
要在 Cloudflare Worker 中对每次请求混淆 JavaScript,安装 @afterpack/wasm,并在 fetch 处理函数里用随机 seed 调用 obfuscate():每个响应都是结构不同、行为相同的脚本。这个包是 AfterPack(afterpack.dev)这款 JavaScript 混淆器的引擎,编译为 WebAssembly;它免费,运行在你自己的 Worker 里。真实的 bundle 会超过免费计划 10 ms 的 CPU 上限,所以请使用 Workers Paid,并按时间窗口缓存一个混淆版本。
下面的一切我都用 wrangler dev 跑过:确切的 Worker 代码、同一 URL 返回两个不同响应体的 curl 输出,以及一个每十分钟而不是每次请求轮换一次的缓存版本。每次请求的代码混淆只需要一个 npm 包和不到二十行 Worker 代码。
AI 让阅读已发布的 JavaScript 变得很便宜:一个 AI 智能体只用了几分钟就把混淆过的演示代码还原成了干净的源码。AfterPack CLI 和框架插件在发布层面应对这一点:每次构建都用新的 seed(发布文章)。在你自己的 Worker 里,同一个引擎把这个节奏推进到每次请求,于是针对某一份脚本写的任何自动化,到下一份都得重写。
每次请求的代码混淆能阻止什么?
针对某一个响应写的 hook、补丁和反混淆脚本,在下一个响应上就失效了,因为标识符、偏移量和解码器位置每次都会变。这对自动化反复针对的脚本很重要:反机器人和挑战脚本、客户端完整性校验,以及爬虫为了绕过它们而打补丁或挂钩的脚本。
每个响应同时也是一次完整的 AfterPack 构建:算法被改写,控制流被展平,标识被融合,所以即使还原出的副本也与你写的代码不同。不过所有响应仍是同一个程序,而且没有任何混淆器(包括 AfterPack)能让还原变得不可能。
如何在 Cloudflare Worker 中安装 JavaScript 混淆器
在 wrangler 旁边安装 @afterpack/wasm,并从中导入 obfuscate。不需要 init 调用、不需要 nodejs_compat 标志,也不需要为 .wasm 文件写 wrangler 规则。
我使用的版本(2026-09-27):@afterpack/wasm 0.1.0、wrangler 4.141.0、Node 24.21.0,机器为 Apple M2 Max。
| npm i @afterpack/wasm wrangler |
@afterpack/wasm 就是 CLI 和插件运行的那个 Rust 引擎,编译成了 WebAssembly;包的 exports 映射会给 wrangler 一个适用于 Worker 的入口(文档)。同样的导入在 Node 中也能用,那里由另一个入口从磁盘读取二进制,不过在普通的 Node 构建中,原生的 @afterpack/core 更快。
演示脚本是一个小型客户端价格计算器。它代替挑战脚本或完整性校验脚本,短到可以手动核对输出:
src/pricing.client.js:被分发的源码
| 1 | const TIERS = [ |
| 2 | { min: 1, max: 9, unit: 12 }, |
| 3 | { min: 10, max: 49, unit: 10 }, |
| 4 | { min: 50, max: Infinity, unit: 8 }, |
| 5 | ]; |
| 6 | |
| 7 | function unitPrice(quantity) { |
| 8 | const tier = TIERS.find((t) => quantity >= t.min && quantity <= t.max); |
| 9 | return tier ? tier.unit : TIERS[0].unit; |
| 10 | } |
| 11 | |
| 12 | export function quote(quantity, coupon) { |
| 13 | let total = unitPrice(quantity) * quantity; |
| 14 | if (coupon === "LAUNCH20" && quantity >= 10) total *= 0.8; |
| 15 | return Math.round(total * 100) / 100; |
| 16 | } |
Worker 以字符串形式导入这个文件,这需要为源文件写一条 wrangler 规则(引擎本身不需要)。wrangler.jsonc:
| 1 | { |
| 2 | "name": "per-request-obfuscation", |
| 3 | "main": "src/worker.js", |
| 4 | "compatibility_date": "2026-09-25", |
| 5 | "vars": { "WINDOW_SECONDS": "600" }, |
| 6 | "rules": [{ "type": "Text", "globs": ["**/*.client.js"], "fallthrough": true }] |
| 7 | } |
如何对每次请求混淆 JavaScript
在 fetch 处理函数里生成随机 seed,传给 obfuscate(),并以 cache-control: no-store 返回结果。这样每个响应都由它自己的 seed 构建。
src/worker.js:
| 1 | import { obfuscate } from "@afterpack/wasm"; |
| 2 | import source from "./pricing.client.js"; |
| 3 | |
| 4 | export default { |
| 5 | async fetch(request) { |
| 6 | if (new URL(request.url).pathname !== "/pricing.js") { |
| 7 | return new Response("Not found", { status: 404 }); |
| 8 | } |
| 9 | const seed = crypto.getRandomValues(new Uint32Array(1))[0]; |
| 10 | const result = await obfuscate({ path: "pricing.js", source }, { preset: "hard", seed }); |
| 11 | return new Response(result.bytes, { |
| 12 | headers: { |
| 13 | "content-type": "application/javascript", |
| 14 | "cache-control": "no-store", |
| 15 | }, |
| 16 | }); |
| 17 | }, |
| 18 | }; |
在 Worker 中,请始终自己传入 seed:正是来自 crypto.getRandomValues 的随机 seed 让每个响应都不同。cache-control: no-store 保证了这一点,否则浏览器、你域名前面的另一个 CDN 或公司代理可能会留住第一个版本,每次请求的工作就白做了。如果之后要复现某个响应,把它的 seed 记到日志里,或放进响应头返回;seed 不是秘密。
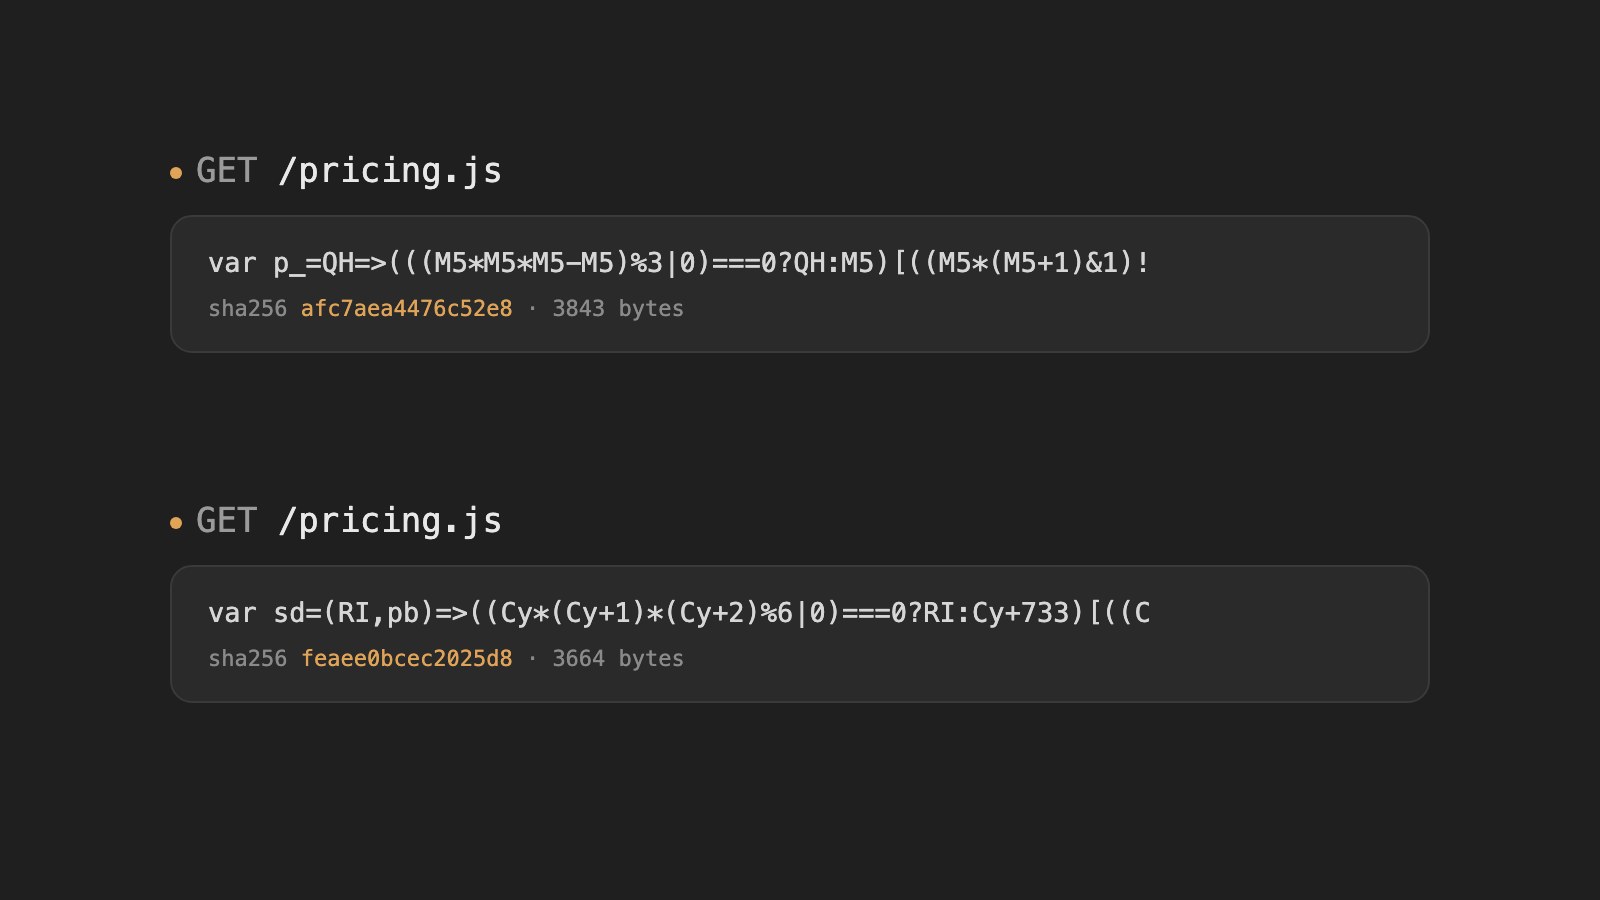
运行 npx wrangler dev,然后请求同一个 URL 两次:
| 1 | $ for i in 1 2; do curl -s localhost:8787/pricing.js | shasum -a 256; done |
| 2 | 0265ae6f5cf5a0839ee52a9a08bab6326503849c66296ae581c2c21923d2d676 - |
| 3 | a5684abbb2ba13be3c182840d30b1f2a634b241013e112be70c6de22ac1233b4 - |
| 4 | |
| 5 | $ for i in 1 2; do curl -s localhost:8787/pricing.js | head -c 100; echo; done |
| 6 | var DA=($d,wS,Uv)=>((tD*(tD+1)&1)===0?(((tD*tD*tD-tD)%3|0)===0?$d:tD^32)[((tD*tD-tD&1)===0?e:tD&739) |
| 7 | var Sg=(H5,xS,nF)=>((Ye*(Ye+1)*(Ye+5)%6|0)===0?H5:Ye+124)[((Ye*(Ye+3)%2|0)!==0?Ye+100:B)](((Ye*(Ye+1 |
| 8 | |
| 9 | $ for i in 1 2; do curl -s localhost:8787/pricing.js | wc -c; done |
| 10 | 3823 |
| 11 | 3545 |
哈希、标识符和长度都不同,两个响应体里都没有 TIERS 或 unitPrice。我把两个响应保存为模块,与原始代码并排对六组数量/优惠券调用 quote();三者返回的总价完全一致。优惠券字符串仍然在里面,运行时编码再解码,这没关系:接单的服务器会重新计算价格并校验优惠券,这份客户端副本只负责显示报价。
如何缓存混淆后的 JavaScript 并每 10 分钟轮换一次
不要随机生成 seed,而是从当前时间窗口推导出来,并用包含窗口的键缓存结果。这样每个地点每个窗口只构建一个混淆版本,并一直提供到窗口结束,访客就不必各自为一次新构建付 CPU:
src/rotating.js:每个窗口一个版本,带缓存
| 1 | import { obfuscate } from "@afterpack/wasm"; |
| 2 | import source from "./pricing.client.js"; |
| 3 | |
| 4 | export default { |
| 5 | async fetch(request, env, ctx) { |
| 6 | const url = new URL(request.url); |
| 7 | if (url.pathname !== "/pricing.js") { |
| 8 | return new Response("Not found", { status: 404 }); |
| 9 | } |
| 10 | |
| 11 | const windowSeconds = Number(env.WINDOW_SECONDS); |
| 12 | const now = Math.floor(Date.now() / 1000); |
| 13 | const slot = Math.floor(now / windowSeconds); |
| 14 | const secondsLeft = (slot + 1) * windowSeconds - now; |
| 15 | const cacheKey = new Request(`${url.origin}/pricing.js?slot=${slot}`); |
| 16 | |
| 17 | let response = await caches.default.match(cacheKey); |
| 18 | if (!response) { |
| 19 | const result = await obfuscate( |
| 20 | { path: "pricing.js", source }, |
| 21 | { preset: "hard", seed: `pricing.js:${slot}` }, |
| 22 | ); |
| 23 | response = new Response(result.bytes, { |
| 24 | headers: { |
| 25 | "content-type": "application/javascript", |
| 26 | "cache-control": `public, max-age=${secondsLeft}`, |
| 27 | }, |
| 28 | }); |
| 29 | ctx.waitUntil(caches.default.put(cacheKey, response.clone())); |
| 30 | } |
| 31 | |
| 32 | response = new Response(response.body, response); |
| 33 | response.headers.set("cache-control", `public, max-age=${secondsLeft}`); |
| 34 | return response; |
| 35 | }, |
| 36 | }; |
上面的配置设置了 600 秒的窗口。为了不等十分钟就看到轮换,我把它改成了 15 秒:
| npx wrangler dev src/rotating.js --port 8788 --var WINDOW_SECONDS:15 |
| 1 | $ for i in 1 2 3 4 5; do |
| 2 | date +%T |
| 3 | curl -s -D headers.txt localhost:8788/pricing.js | shasum -a 256 | cut -c1-16 |
| 4 | grep -i cache-control headers.txt |
| 5 | sleep 4 |
| 6 | done |
| 7 | 15:03:46 |
| 8 | 951fdcf8a3cf73ef |
| 9 | Cache-Control: public, max-age=14 |
| 10 | 15:03:50 |
| 11 | 951fdcf8a3cf73ef |
| 12 | Cache-Control: public, max-age=10 |
| 13 | 15:03:54 |
| 14 | 951fdcf8a3cf73ef |
| 15 | Cache-Control: public, max-age=6 |
| 16 | 15:03:58 |
| 17 | 951fdcf8a3cf73ef |
| 18 | Cache-Control: public, max-age=2 |
| 19 | 15:04:03 |
| 20 | 4120ce5292b9cf92 |
| 21 | Cache-Control: public, max-age=12 |
窗口内字节相同,窗口过后字节变化,max-age 一路倒数到边界。
让这一切成立的有三个细节:
- 相同的 seed 产生相同的字节。 在我的测试中,相同的 seed 字符串、源码和包版本在重复调用时输出完全一致。Cloudflare 的 Cache API 不会复制到存储该条目的数据中心之外(Cloudflare 文档),所以每个地点在第一次未命中时构建自己的副本;由于 seed 来自窗口,运行同一部署版本的所有地点在该窗口内应当提供相同的字节。seed 不是秘密:它只能让人用你的源码复现输出,而别人没有你的源码。
- 浏览器拿到的是剩余时间,而不是存储时的时间。 缓存命中会带着存储时的响应头返回,所以 Worker 在返回时重写
cache-control。否则,在窗口末尾命中的浏览器会把旧版本多留最多一个窗口。slot 在缓存键里,所以新窗口永远不会读到旧条目。 - 在本地或你自己的域名上测试缓存。 Cache API 在控制台编辑器和 Playground 预览中不起作用,所以请使用
wrangler dev或已部署的路由。
在 Worker 中混淆要花多少 CPU?
对这个 16 行的文件,在 wrangler dev 下预热后每次请求耗时 4–12 ms。真实的 bundle 每次构建在 light 下需要数百毫秒,在 hard 下需要数秒,远超 Workers 免费计划 10 ms 的 CPU 上限。
在我的 M2 Max 上对 wrangler dev 做了五次冷启动,第一次请求耗时 59–338 ms(包括引擎启动),之后稳定在 4–12 ms。这些是本地 workerd 进程中的请求耗时,而不是边缘 isolate 中的 CPU 时间,所以在规划之前请先在 Cloudflare 上实测。作为参照,文档在 Node 中对一个 185 KB 的 bundle 测得 light 下 271 ms、medium 下 1,558 ms;本演示使用 hard,即复杂度 12(预设)。
引擎在两种计划下都满足 Worker 的大小限制。只要比极小的脚本大,免费计划就会因 CPU 上限而不可用(文档)。
按请求、按窗口还是按构建?
大型 bundle 和页面加载路径上的一切按构建混淆;想低成本轮换的脚本按窗口混淆;只有在有人反复对你的脚本运行同一套自动化时才按请求混淆。
| 节奏 | 在哪里运行 | 构建次数 | 缓存 | 适用于 |
|---|---|---|---|---|
| 按构建 | CLI 或插件,在 CI 中 | 每次部署一次 | 你的 CDN,和其他文件一样 | 大型 bundle、页面加载的关键路径 |
| 按窗口 | 你的 Worker,seed 来自时间槽 | 每个窗口每个地点一次 | Cache API,max-age = 剩余秒数 | 想轮换又不想按访客付费的脚本 |
| 按请求 | 你的 Worker,随机 seed | 每次请求一次 | no-store | 反机器人和挑战脚本、完整性校验、爬虫会打补丁的脚本 |
如何从 Worker 运行 Pro 混淆
传入 key,例如来自 Worker secret 的 { key: env.AFTERPACK_KEY },同一个 obfuscate() 调用就会在 AfterPack 的云端运行 Pro。你安装的包本身执行 Free 级别的保护。
这个调用应放在轮换 Worker 里,而不是按请求的 Worker 里,否则每个访客都要等待一次云端构建的往返。还要注意窗口长度:Pro 按处理的 MB 计费,而每个地点每个窗口都会构建自己的副本。一个 20 KB 的脚本,窗口 10 分钟,30 个地点,每天大约 86 MB,每月 2.6 GB,远超 Indie 的 500 MB。窗口改为 6 小时,同一个脚本每月大约 72 MB。
每次云端构建也都是一次有记录的构建,带有自己的 Protection Map,而一个项目只保留最近 500 次,所以请为轮换 Worker 构建所用的项目关闭 map 存储。为了这次调用,你的源码会离开 Worker,在内存中处理后丢弃(隐私)。如果云端不可达,调用会失败即关闭:抛出异常,不会发出任何未受保护的内容。捕获这个异常并提供之前窗口保存的版本,否则访客会收到错误。
动手试试
复制上面的三个文件(wrangler.jsonc、src/worker.js、src/pricing.client.js),运行 npm i @afterpack/wasm wrangler 和 npx wrangler dev,然后对 /pricing.js curl 两次。包的参考文档是在 Cloudflare Worker 中混淆 JavaScript;改写时请保留本文中显式传入的 seed。
常见问题
能在 Cloudflare Workers 免费计划上混淆 JavaScript 吗?
只适用于极小的脚本,即便如此,每个 isolate 的第一次请求(在 wrangler dev 下 59–338 ms 的请求耗时,含引擎启动)也可能超过免费计划 10 ms 的 CPU 上限。请使用 Workers Paid,最好配合上面的按窗口缓存。
按请求混淆会拖慢我的网站吗?
对这个 16 行的脚本,在 wrangler dev 下预热后的请求耗时 4–12 ms,每个 isolate 的第一次请求耗时 59–338 ms。使用按窗口缓存时,只有每个地点每个窗口的第一次请求会构建;大多数缓存命中在 2–3 ms 内返回。按构建混淆不会增加任何请求时开销。
按请求混淆能阻止网页爬虫和机器人吗?
它会让针对某一个响应编写的 hook、补丁和爬虫失效,因为下一个响应就是另一个脚本。它不能阻止人阅读某个响应,本身也不检测机器人;它提高的是针对你的反机器人检查所依赖脚本做自动化的成本。
按请求混淆 JavaScript 能隐藏 API 密钥吗?
不能。浏览器需要的任何东西,浏览器都能读到,不管它以什么形式到达。把密钥以及最终价格、优惠券是否有效这类决定留在服务器上,就像演示里那样。如何保护 JavaScript 源代码 介绍了如何检查你的网站已经发出了什么。
AfterPack 能在没有我自己的 Worker 的情况下提供按请求混淆吗?
暂时不能。它在路线图上,尚未发布。在那之前,上面的 Worker 就是全部集成,而更难的问题是:你的哪些脚本真的有人每天对它运行同一套自动化?